Medí Code Mode con mi servidor MCP: en Claude Code hizo el doble de peticiones al modelo y gastó un 44 % menos que llamando a las tools una a una; con 20 llamadas encadenadas, 4,7 veces menos.
 José Antonio Garrido
En Claude Code, con mi servidor MCP, google-docs-mcp, Code Mode hizo más del doble de peticiones al modelo (13 frente a 5) y aun así costó un 44 % menos que llamando a las herramientas una a una. La razón es que los resultados de las herramientas se quedan en una variable del script y no entran en el contexto.
Cuando un agente llama una a una a las herramientas de un servidor MCP, cada resultado vuelve entero al modelo, aunque solo necesite contar tres cosas de él. Code Mode cambia eso: el agente escribe un script que llama a las herramientas, filtra los resultados en código y solo devuelve lo que importa. Esta semana Claude Code lo ha estrenado como experimento y han vuelto los titulares de “MCP ha muerto” y “ahorra un 98 % de tokens”. En vez de repetir esas cifras, las he medido.
Lo que sale, en resumen:
- Con 20 llamadas encadenadas, gana por mucho. 4,7 veces más barato que el modo clásico en la API. En Claude Code, con tres llamadas a mi servidor real, un 44 % menos que llamando a las herramientas una a una.
- Con una sola llamada, no compensa. Tarda el doble que el modo clásico (14 s frente a 7 s) y tool search sale más barato (0,006 $ frente a 0,012 $).
- Con cientos de herramientas, no es lo que ayuda. Lo que ayuda es la búsqueda de herramientas (tool search).
- Los tokens no son dinero. 118.000 tokens de definiciones costaron 0,016 $ con la caché caliente.
Todo es reproducible: el banco de pruebas está en yeyo11/mcp-code-mode-bench, con el servidor, las tareas, los registros de cada ejecución y la tabla.
Qué es Code Mode, y por qué hay tres
En lugar de darle al modelo una herramienta por cada operación y esperar a que las llame de una en una, le das una sola herramienta que ejecuta código, y tus herramientas MCP pasan a ser funciones que ese código puede llamar. Los resultados intermedios se quedan en variables del script y no pasan por el contexto del modelo. La idea es anterior al nombre: el artículo CodeAct (febrero de 2024) ya usaba código ejecutable como acción del agente, y CodeAgent de smolagents la llevó al código abierto en diciembre de 2024. El nombre lo puso Cloudflare en septiembre de 2025.
Hoy “Code Mode” son tres cosas distintas, y conviene no mezclarlas:
- Cloudflare Code Mode, en el servidor. Convierte las herramientas MCP en una API de TypeScript y ejecuta el código del modelo en un isolate de V8. En febrero lo aplicó a toda su API: más de 2.500 endpoints detrás de dos herramientas,
searchyexecute. - Programmatic tool calling, en la API de Claude. Claude escribe Python en el contenedor de ejecución de código y desde ahí llama a tus herramientas. Salió en beta el 24 de noviembre de 2025 y no necesita cabecera de beta desde el 17 de febrero de 2026. El patrón lo explica Anthropic en Code execution with MCP.
- Code Mode de Claude Code, en el cliente. Claude escribe JavaScript que llama a Bash, Read, Edit y a tus herramientas MCP a través de una herramienta llamada
REPL. Llegó como experimento en la versión 2.1.323, el 12 de noviembre de 2026; por eso se habla de esto ahora.
Las cifras que circulan, con su contexto
Antes de medir, revisé de dónde sale cada número que se repite estos días:
- De 150.000 a 2.000 tokens (98,7 %) es de Anthropic, y se refiere a cargar las definiciones de herramientas bajo demanda, no al ejemplo de Google Drive a Salesforce del mismo artículo. No publica cómo lo midió.
- De 1,17 millones a unos 1.000 tokens es de Cloudflare. El punto de partida es hipotético: un servidor con una herramienta por endpoint que nunca existió.
- El 78 % “independiente” es una prueba de AIMultiple con 2 consultas, GPT-4.1 y el servidor MCP de Bright Data (63 herramientas). La propia página indica que Bright Data está suscrito a sus benchmarks. Y la mayor parte del ahorro viene de no cargar 63 definiciones, no de filtrar en código.
- El 37 % es programmatic tool calling en la API (de 43.588 a 27.297 tokens de media), no Code Mode de Claude Code. Anthropic no ha publicado cifras de Code Mode en Claude Code.
Cómo lo he medido
Para la API construí un servidor MCP de pega con las mismas 6 herramientas que google-docs-mcp (list_documents, list_comments, get_comments_summary, get_comment, get_document, get_auth_status), los mismos esquemas y el mismo formato de salida. Responde con datos inventados: 20 documentos de la carpeta “Q4 planning” de un equipo ficticio, con 300 comentarios, hilos de respuestas, comentarios reabiertos y borrados. No hay inicio de sesión, y “hoy” es siempre el 20 de noviembre de 2026, así que la respuesta correcta se calcula de antemano y cada ejecución la corrige el código, no yo.
Tres tareas:
| Tarea | Qué pide | Forma |
|---|---|---|
| T1 | En todos los documentos, qué comentarios abiertos llevan más de 7 días sin respuesta, agrupados por documento y contados por autor | 20 llamadas encadenadas a list_comments, una por documento, con resultados grandes y una respuesta pequeña (21 contando el list_documents inicial) |
| T2 | Cuántos comentarios abiertos tiene el documento “Budget 2027” | Una llamada: el caso en el que Code Mode no debería compensar |
| T3 | T2 con 200 herramientas de relleno en el catálogo (206 en total) | Lo que cuestan solo las definiciones |
Y tres modos, con el mismo modelo (Sonnet 5.5), el mismo esfuerzo (medium) y el mismo prompt:
- A. Clásico: cada resultado vuelve al modelo.
- B. Clásico con tool search: todas las herramientas con
defer_loading: truemenoslist_documents, y el modelo busca las que necesita. - C. Programmatic tool calling:
code_execution_20260120yallowed_callersen cada herramienta.
De cada ejecución sumo los tokens de todas las peticiones del bucle (entrada sin caché, escrituras y lecturas de caché), los de salida, el número de peticiones, el tiempo y el coste con la tabla de precios de Anthropic. Cinco repeticiones por tarea y modo, 45 ejecuciones en total, todas correctas. Me costaron 5,54 $.
Después repetí la comparación en Claude Code con mi servidor de verdad, clásico contra Code Mode.
Resultados en la API
Medianas de 5 ejecuciones con la caché caliente:
| Tarea | A. Clásico | B. Tool search | C. Programmatic tool calling |
|---|---|---|---|
| T1, 20 llamadas encadenadas | 0,281 $ · 77k de entrada · 11,3k de salida · 79 s | 0,283 $ · 80k de entrada · 75 s | 0,060 $ · 44k de entrada · 3,8k de salida · 57 s |
| T2, una llamada | 0,018 $ · 7 s | 0,006 $ · 7 s | 0,012 $ · 14 s |
| T3, una llamada, 206 herramientas | 0,016 $ · 118k de entrada | 0,005 $ · 11k de entrada | 0,029 $ · 161k de entrada |
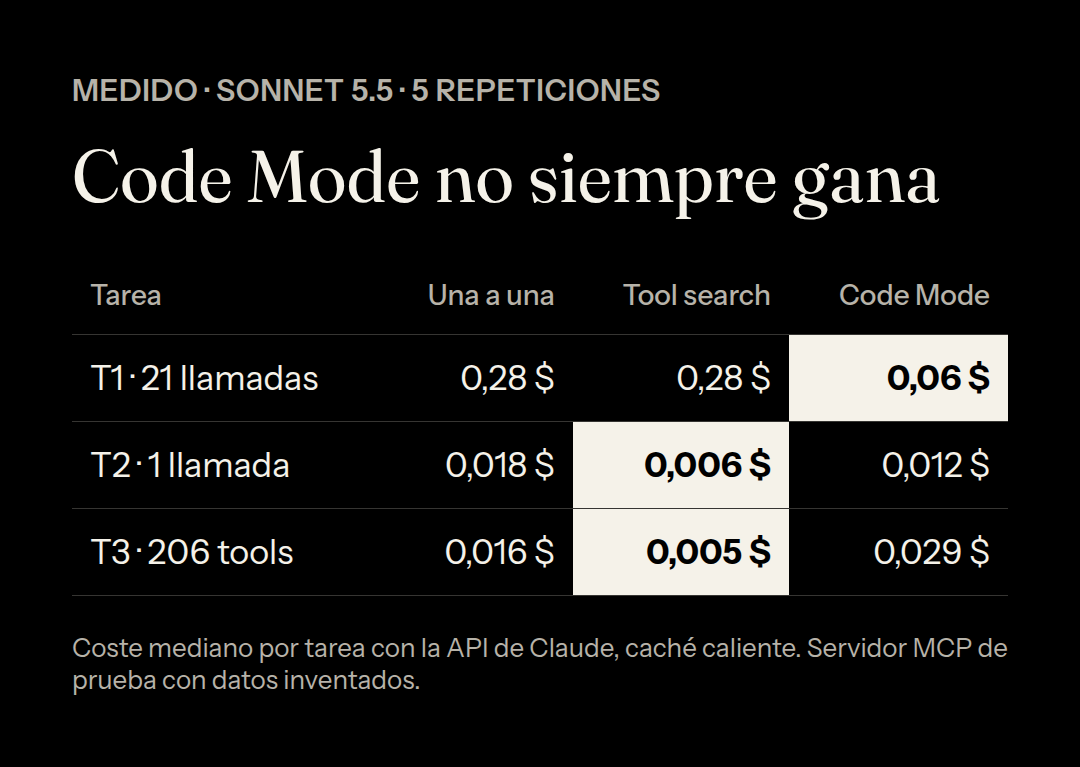
Con la caché fría (una ejecución de cada): en T1, 0,288 $ el clásico frente a 0,083 $ con código; en T3, 0,118 $ el clásico, 0,020 $ con tool search y 0,110 $ con código.
Un detalle de T1 que sorprende: el modo clásico hace solo 3 peticiones al modelo, porque el modelo lanza las 20 llamadas a list_comments en paralelo en un mismo turno. Programmatic tool calling hace 24, porque cada llamada que hace el script vuelve a tu bucle para que la ejecutes. Aun así cuesta casi cinco veces menos que el clásico: esos resultados no entran en el contexto ni se facturan como entrada, y el modelo escribe 3.800 tokens en vez de 11.300.
Con mi servidor real, en Claude Code
La tarea, sobre tres documentos de diseño públicos con comentarios (dos de Kubernetes y uno de OpenTelemetry): en cada documento, qué hilos abiertos tienen como último mensaje una respuesta de otra persona, es decir, dónde el autor del comentario debe una respuesta. La respuesta correcta es 4, 8 y 0, y todas las ejecuciones la dieron.
Claude Code 2.1.330, Sonnet 5.5, sesiones interactivas, 3 repeticiones de cada modo intercaladas:
| Modo | Peticiones al modelo | Tokens de entrada (escritos en caché) | Salida | Tiempo | Coste estimado |
|---|---|---|---|---|---|
| Clásico | 5 (4–6) | 256k (unos 38k) | 2.251 | 21 s | 0,191 $ |
| Code Mode | 13 (12–14) | 170k (unos 18k) | 1.739 | 21 s | 0,107 $ |
Medianas. El coste es una estimación a precios de la API: yo lo ejecuté con mi suscripción, donde no se paga por ejecución, sino que gasta cuota.
Frente al modo clásico, Code Mode hace más del doble de peticiones al modelo, tarda lo mismo y aun así sale un 44 % más barato. La diferencia está en la caché: Claude Code relee su prompt de sistema en cada petición, y esas lecturas son baratas. Lo que cuesta es escribir en caché, y en Code Mode los resultados de las tres llamadas MCP nunca llegan al contexto, así que se escribe la mitad.
Con Ctrl+O ves el código que escribe Claude. Este es el script que hace el trabajo (lo he formateado y acortado los identificadores):
const ids = ["12F1YXsv…", "1q4a8uB_…", "1y63W66E…"];
const out = {};
for (const id of ids) {
  out[id] = await tools["mcp__google-docs__list_comments"]({
    document: id, status: "open", format: "json", max_results: 100,
  });
}
globalThis.out = out;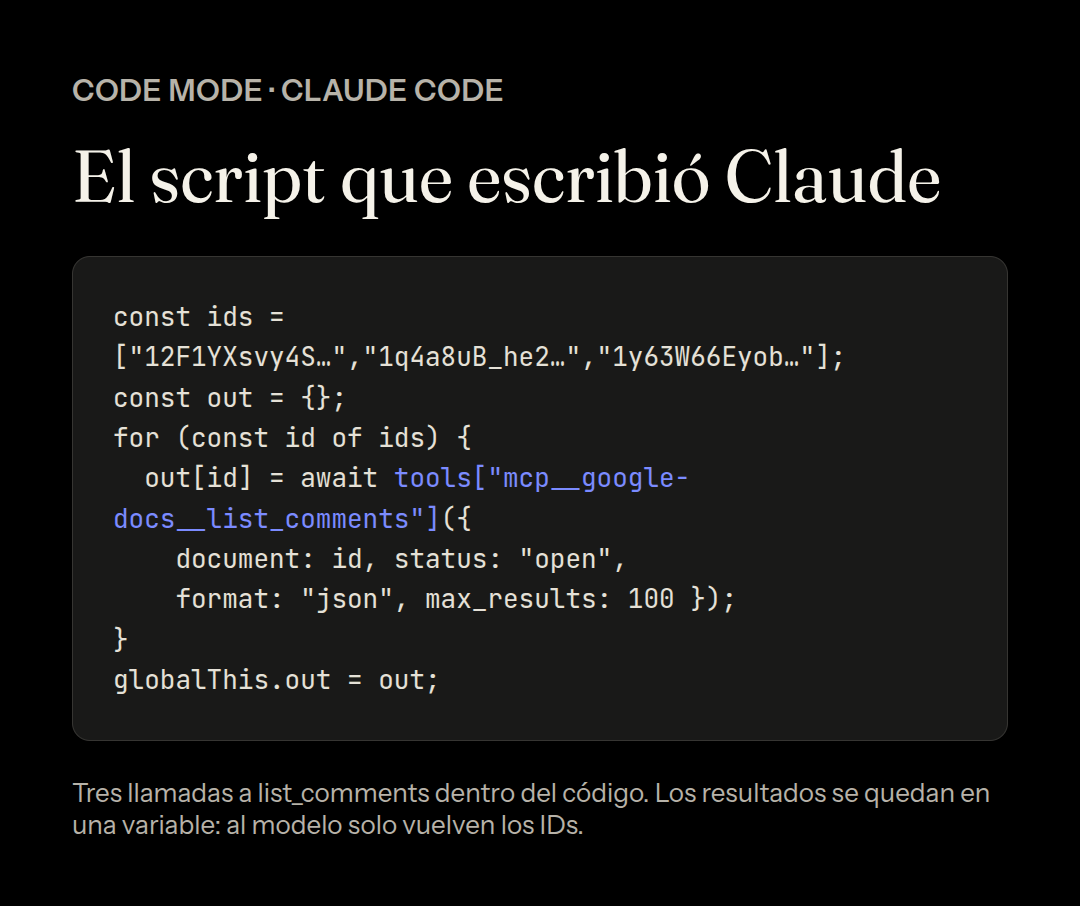
Las tres respuestas se quedan en globalThis.out, y Claude solo ve la longitud de cada una. En los scripts siguientes filtra en código los hilos cuya última respuesta no es del autor y devuelve las listas de identificadores. El modelo nunca lee los comentarios.
Para activarlo necesitas Claude Code 2.1.323 o posterior, una sesión interactiva en el terminal y esta variable:
CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 claudeLa primera vez te pregunta si quieres activarlo; respondes que sí y reinicias. Con claude -p no funciona: la herramienta REPL no aparece. Y si lanzas claude desde dentro de otra sesión de Claude Code, el proceso hereda variables CLAUDE_* y te dice que Code Mode no está disponible en ese tipo de sesión; arráncalo sin ellas.
Lo que dicen los números
Gana cuando hay muchas llamadas encadenadas cuyos resultados solo hay que filtrar. No por hacer menos peticiones al modelo, porque hace más, sino porque los resultados intermedios no entran en el contexto y el modelo escribe mucho menos. En T1, con 20 llamadas encadenadas, 4,7 veces más barato que el modo clásico en la API; con mi servidor en Claude Code, un 44 % menos que llamando a las herramientas una a una.
Con una sola llamada, no compensa. En T2 tarda el doble que el modo clásico (14 s frente a 7 s) y tool search sale más barato (0,006 $ frente a 0,012 $). Escribir el script y arrancar el contenedor tiene un coste fijo que una llamada pequeña no amortiza.
Con cientos de herramientas, lo que funciona es tool search. Programmatic tool calling, tal como lo ofrece la API, sigue cargando todas las definiciones: en T3 lee 161k tokens. Tool search lo deja en 11k y sale 6 veces más barato que el modo clásico con la caché fría y 3 con la caliente. Las dos herramientas de Cloudflare, search y execute, funcionan porque combinan las dos ideas: buscar qué llamar y luego llamarlo desde código. Decir que Code Mode resuelve 2.500 endpoints las mezcla. Claude Code, por cierto, ya aplaza las definiciones de las herramientas MCP detrás de su propia búsqueda, así que esa parte la tienes resuelta también en modo clásico.
Los tokens no son dinero. En T3 el modo clásico lee 118.000 tokens de definiciones y cuesta 0,016 $, porque casi todo son lecturas de caché, que en Sonnet 5.5 cuestan el 5 % del precio de entrada. La factura depende de lo que se escribe en caché y de lo que genera el modelo, no del total de tokens.
Una ejecución no demuestra nada. El mismo prompt clásico en Claude Code fue de 4 a 6 peticiones al modelo y de 189k a 327k tokens de entrada entre repeticiones. Con claude -p, dos ejecuciones idénticas dieron 5 y 11 turnos. Si comparas modos, repite.
Qué cubre esta medición
Un servidor de pega con datos inventados, para que cualquiera pueda reproducirlo, y una comparación con mi servidor real. Un modelo (Sonnet 5.5) con un esfuerzo (medium). Cinco repeticiones por celda en la API y tres por modo en Claude Code: bastan para ver la dirección, no para discutir decimales. El servidor de pega responde sin latencia; con uno real, que espera a la API de Google, cada vuelta de más pesa más en el tiempo, en todos los modos. Cloudflare Code Mode queda fuera: es otra pila y desplegarlo pide el plan de pago de Workers.
Sobre la seguridad, en Claude Code cada llamada sigue pasando por tus reglas deny y ask y por los hooks PreToolUse. En modo auto, en cambio, el clasificador revisa el código y no cada llamada, y no ve los valores que se calculan al ejecutarlo. Y según la documentación, el JavaScript y sus llamadas a ficheros, web y MCP se ejecutan fuera del sandbox; solo los comandos de shell que lanza van dentro.
Repítelo tú
Node 20 o posterior. Los modos de la API necesitan ANTHROPIC_API_KEY; el resto es gratis.
git clone https://github.com/yeyo11/mcp-code-mode-bench
cd mcp-code-mode-bench
npm install
npm test

# La petición exacta que enviaría un modo, sin enviarla ni necesitar clave
npm run bench -- api --dry-run --mode C --task T2

# Los tres modos de la API intercalados, 5 repeticiones, con tope de gasto
npm run bench -- api --mode A,B,C --task T1,T2,T3 --reps 5 --cap 9
npm run report
El tope (--cap, en dólares) para toda la ejecución en cuanto se alcanza. --model cambia el modelo y --padding el tamaño del catálogo. Los pasos para medir Code Mode de Claude Code desde una sesión interactiva están en docs/claude-code-code-mode.md.
Si quieres enterarte del próximo experimento de este tipo, suscríbete a la newsletter aquí abajo.
Tu turno
Esto es lo que me queda abierto, y me interesa más tu experiencia que la mía:
- ¿Dónde debería vivir Code Mode, en el cliente o en el servidor MCP? Cloudflare lo pone en el servidor; Claude Code, en el cliente. En el cliente, cada servidor no tiene que montar su propio sandbox; en el servidor, no dependes de que tu agente lo soporte.
- ¿Te compensa aprobar un programa en vez de cada llamada? Sobre todo en modo auto, donde nadie ve los valores que se calculan al ejecutarlo.
- ¿A partir de cuántas herramientas o cuántas llamadas te sale a cuenta? En mis tareas, con una llamada no; con 20 encadenadas, sí.
Y si tienes otro modelo a mano, ejecuta el banco con --model y publica tus números en una issue del repositorio. Si te salen distintos de los míos, mejor: es justo lo que quiero ver.