Sluicev0.12.2
Cómo Sluice hace que hasta 10 agentes de IA compartan un equipo Linux de 30 GB sin pisarse: una cola, techos de memoria del kernel y Chromium en su sitio.
 José Antonio Garrido
Durante las dos semanas siguientes a publicar Sluice 0.8.0, lo usé a diario en mis dos máquinas, las dos con 30 GiB de RAM, con hasta 10 agentes de IA trabajando a la vez en una de ellas. Sluice pone en una sola cola los tests, builds y comandos pesados de todos los agentes de IA de una máquina Linux, con un presupuesto común de CPU y memoria, y ejecuta cada comprobación una sola vez por árbol de git; te conté cómo empezó en el primer artículo. Aun con esa cola, los tests de mis agentes seguían pudiendo dejar una máquina sin memoria. Cómo conviven ahora, en resumen: la cola decide quién corre, los techos del kernel mantienen cada trabajo dentro de su parte y la protección del escritorio deja libre la del escritorio. Esto es lo que aprendí, y cada lección se convirtió en una versión, de la 0.9.0 a la 0.12.2:
- Un reintento sigue siendo la misma suite (0.9.0). La admisión por memoria pasa la estimación de un gate a sus variantes y espera tras cada muerte por memoria.
- Cuando la máquina pagina, solo el kernel llega a tiempo (0.10.0). Cada trabajo de gate (tests, linters, type checks) corre bajo un techo de memoria que impone el kernel, aunque todo lo demás esté bloqueado.
- Un navegador no se queda donde lo lanzas (0.11.0). Chromium, y por tanto cualquier navegador de Playwright, se sale de su trabajo; Sluice lo devuelve, así que su memoria cuenta, tiene límite y muere con el trabajo.
- El escritorio tiene que poder opinar (0.11.0). Cada trabajo tiene también un techo de swap, y ninguno arranca mientras tu sesión de escritorio se atasca por falta de memoria.
- El entorno también es parte de lo que pruebas (0.11.0). Variables como
NODE_OPTIONSentran en la clave de caché. - Un daemon no debe heredar a quien lo arranca (0.12.0). El entorno de la sesión de un agente, token incluido, ya no llega a los trabajos de todos.
Un reintento sigue siendo la misma suite
Una semana después de publicar la 0.8.0 revisé lo que había pasado en mi segunda máquina: 12 hilos, 30 GiB de RAM, 8 GiB de swap y entre 4 y 10 agentes trabajando a la vez. En 37 horas hubo 11 OOM globales, 7 procesos matados por systemd-oomd, 16 trabajos de tests matados por memoria y una sesión de agente que cayó con ellos. La swap estaba llena en todos.
Había cuatro causas:
- Tras una muerte, los agentes reintentaban con
--filtero--test-concurrency=1. Para Sluice era un comando nuevo, sin historial, así que estimaba 1,3–1,7 GiB para una suite que necesita 11–14 GiB. - El margen de seguridad tras una muerte se acumulaba hasta 1,5×.
- La memoria fuera de la cola (agentes, builds, navegadores) crecía mientras corría una suite.
- La ventana de
systemd-oomdde los agentes era de 5 s, y se llevó por delante a un agente 6 s después de que mataran un trabajo de tests.
La 0.9.0 cambió la admisión por memoria:
- Una variante de un comando con otros argumentos hereda la estimación de su gate en vez de una suposición.
- Solo una suposición puede arrancar como sonda.
- El margen tras una muerte es de 1,25×.
- Tras cualquier muerte por memoria, no arranca nada durante 10 s, ni hasta que baja la presión.
- La reserva de memoria crece hasta lo que creció el resto de la máquina mientras corrían trabajos pesados (el percentil 90, como mucho una cuarta parte de la RAM).
- La ventana de
systemd-oomdde los agentes es de 15 s y la de los trabajos de 8 s, así que el trabajo siempre cae antes.
sluice status dice ahora de dónde sale la reserva y marca el trabajo que ha arrancado solo por encima de su estimación. No hay que tocar la configuración.
Cuando la máquina pagina, solo el kernel llega a tiempo
Con la 0.9.0, la misma máquina se topó con el siguiente muro. Entre el 30 de octubre y el 1 de noviembre una misma suite corrió 61 veces, siempre sola en la máquina y por encima de su estimación: 46 pasaron, 9 fallaron sus tests y 6 murieron por memoria. Cada una de esas seis muertes fue un OOM global, y antes de cada una el journal del sistema se quedó callado 22, 30, 37, 67, 72 y unos 150 segundos. La máquina entera estaba paginando, y systemd-oomd y la protección del propio Sluice estaban bloqueados con todo lo demás: lo que corre en espacio de usuario llega tarde.
La 0.10.0 le pasa ese trabajo al kernel. Cada segundo, el daemon escribe el memory.max del cgroup de cada trabajo para que, entre todos, nunca dejen la máquina por debajo de un suelo. El kernel lo aplica aunque el daemon esté congelado. Viene activado por defecto con la contención completa:
# ~/.config/sluice/config.toml
[admission]
memory_reserve = "auto"   # una décima parte de la RAM: 3 GiB de 30 GiB
memory_ceiling = true
memory_floor = "auto"     # la mitad de la reserva: 1,5 GiB de 30 GiB
sluice status muestra el techo de cada trabajo en marcha. Desde el 2 de noviembre, los 387 trabajos siguientes en esa máquina corrieron sin ningún OOM ni muerte por memoria, y la swap no pasó del 36 %.
El precio es a propósito: una ejecución que antes pasaba empujando al resto de la máquina a la swap ahora muere dentro de su propio trabajo. La máquina sigue usable, y el mensaje le dice al agente que lo reintente cuando haya memoria libre o que te avise de que el gate no cabe.
Un navegador no se queda donde lo lanzas
El 5 de noviembre le tocó a mi equipo de desarrollo: 20 hilos, 30 GiB de RAM, 8 GiB de swap, GNOME en Wayland y Sluice 0.10.0. Entre las 18:40 y las 19:20, una suite de tests de frontend de unos 14,5–15 GiB arrancó con el triple de su estimación, los trabajos de Playwright ocupaban 7,7–9,4 GiB cada uno, y a la vez corría un build de producción fuera de Sluice. La máquina llegó a 21 GiB usados (66 %), la swap pasó de 3,6 a 5,2 GiB, la escritura a swap llegó a 1.759 páginas por segundo, la carga a 32 y el retardo de entrada de GNOME Shell a 61–80 ms. No hubo OOM ni se mató nada: el techo de la 0.10.0 no llegó a actuar. El shell acabó sin responder, y a las 20:37 reinicié con SysRq.
Todavía no sé qué colgó el shell: siguió colgado cuando la memoria ya se había recuperado. Pero investigándolo encontré otra cosa. Ese día systemd había creado 385 scopes de Chromium en la máquina, y ahí habían ido a parar los navegadores que lanzaban los tests: fuera de sus trabajos.
Esto es lo que pasa. Al arrancar, cada proceso de navegador de Chromium, también en modo headless, prepara la conexión con el portal de escritorio XDG. El portal necesita un identificador de aplicación, y Chromium lo consigue pidiéndole al gestor de usuario de systemd, por el bus de sesión, un scope nuevo con su propio pid: StartTransientUnit. El proceso acaba en app.slice/app-org.chromium.Chromium-<pid>.scope. No hay ninguna opción para desactivarlo.
Para quien ejecuta trabajos, eso significa que la memoria del navegador sale de la cuenta del trabajo, de su pico aprendido, de su memory.max y de su muerte. Y Playwright lanza los navegadores en un grupo de procesos propio, así que matar el grupo de procesos tampoco los alcanza.
Lo comprobé el 6 de noviembre con una sonda: un headless shell de 6 a 8 segundos y unos 200 MB. El proceso del navegador se fue a su propio scope; los renderers que ya había creado se quedaron en el trabajo.
Los arreglos baratos no aguantaban:
- Quitar
DBUS_SESSION_BUS_ADDRESSsolo sirve para Chromium, y rompe los tests que necesitan el bus de sesión. - El truco de
FLATPAK_SANDBOX_DIR, que se salta el movimiento, dejó de funcionar en Chromium el 14 de octubre. - Un namespace de cgroup no ayuda: systemd hace el movimiento desde el namespace raíz.
Lo que funciona es una propiedad de cgroup v2. Para mover un proceso, el kernel solo pide permiso de escritura en el cgroup.procs del ancestro común de los dos cgroups, y ese ancestro es user@UID.service, que es tuyo. Así que desde la 0.11.0, cada segundo el daemon recorre el árbol de procesos de cada trabajo y devuelve a su cgroup a cualquier descendiente que encuentre fuera. Este es un trabajo en la 0.12.1 que lanza directamente el Chromium headless de Playwright (156). El navegador se sale de su cgroup 265 ms después de arrancar el trabajo, y vuelve en el mismo ciclo:
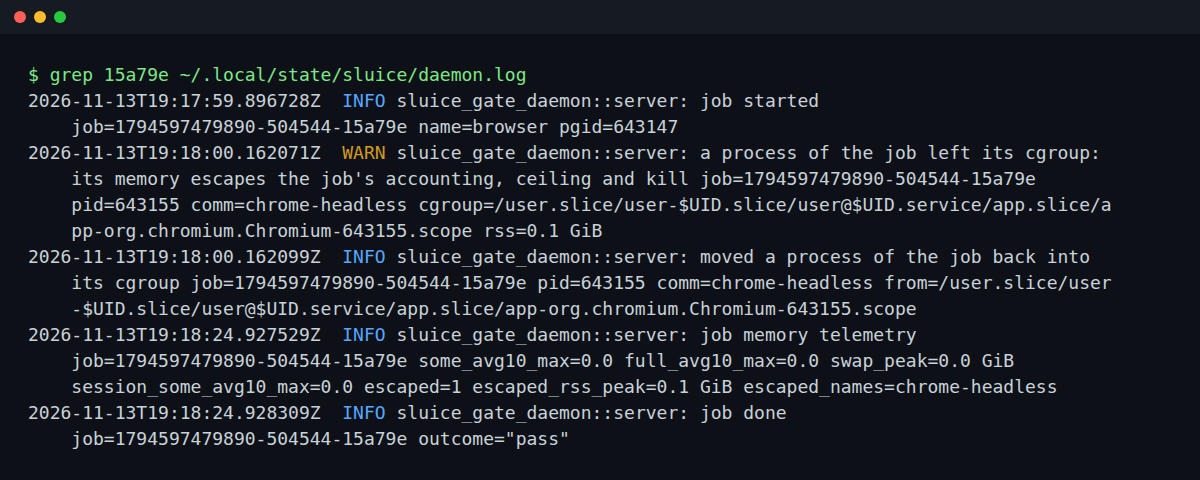
INFO sluice_gate_daemon::server: moved a process of the job back into its cgroup job=1794597479890-504544-15a79e pid=643155 comm=chrome-headless from=/user.slice/user-$UID.slice/user@$UID.service/app.slice/app-org.chromium.Chromium-643155.scopeCuando el trabajo termina, lo que quede de él muere, dentro de su cgroup o fuera: los fugados, a través de un pidfd y después de comprobar la hora de inicio del proceso, para no mandar nunca la señal a un pid reutilizado. Un test de integración reproduce la fuga con la misma llamada a StartTransientUnit.
Viene activado por defecto ([containment] reclaim_escaped = true) y vale para todos los trabajos: el ajuste está en tu configuración de usuario, no en cada gate. Si tus tests lanzan algo a propósito con systemd-run --user --scope, o dejan un proceso en segundo plano que tiene que sobrevivir al trabajo, el daemon también los devolverá; para ese caso, ponlo a false y Sluice solo avisará de las fugas. Lo que coloca el propio Sluice, en su scope de agentes o en cualquier slice por debajo del suyo (como cuando un test ejecuta Sluice dentro de un trabajo), no cuenta como fuga. Todo lo demás, los scopes de Chromium incluidos, vuelve a su trabajo.
El escritorio tiene que poder opinar
La misma 0.11.0 añade dos límites más:
[admission]
swap_ceiling = true
swap_floor = "auto"     # una cuarta parte de la swap
desktop_guard = true- Techo de swap. Cada segundo el daemon escribe también el
memory.swap.maxde cada trabajo, para que entre todos no dejen la swap libre por debajo del suelo. Un trabajo que llega a su techo de memoria muere en su propio cgroup en vez de mandar la máquina entera a la swap. - Protección del escritorio. Sluice lee la presión de memoria de tu sesión de escritorio (
session.slicedel gestor de usuario de systemd). Mientras está en el 10 % o más (some avg10, hasta que baja del 5 %), no arranca ningún trabajo, ni siquiera solo en la máquina, y los techos dejan libre la reserva entera.
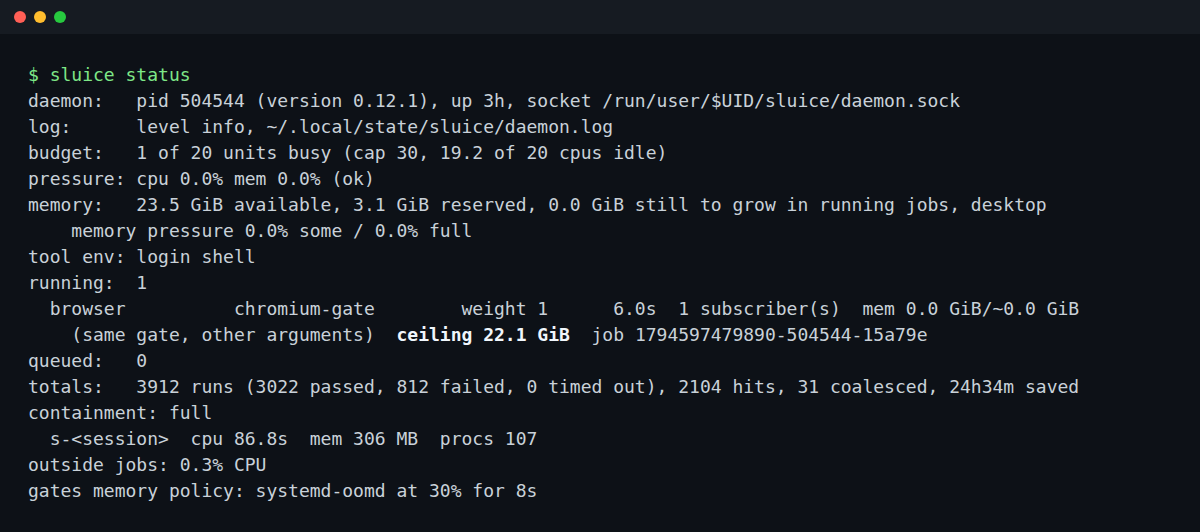
Tus trabajos esperarán mientras el escritorio esté bajo presión; esa es la idea. sluice status muestra el techo de cada trabajo en marcha y la presión de la sesión en su línea memory:. Aquí, con un solo trabajo ligero en una máquina tranquila, así que no salen la swap, la presión ni las fugas, que solo aparecen cuando no son cero:
El entorno también es parte de lo que pruebas
También en la 0.11.0: una variable como NODE_OPTIONS o RUSTFLAGS cambia lo que comprueba un test sin cambiar el árbol. Con key_env su valor entra en la clave de caché, y las peticiones con otros valores nunca comparten un resultado. sluice init las escribe según la toolchain, junto con el fichero que el gestor de paquetes reescribe en cada instalación. En un proyecto npm de usar y tirar:
[gates.test]
cmd = "npm test"
weight = "auto"
timeout = "30m"
hooks = ["pre-push"]
key_inputs = ["node --version", "npm --version"]
key_env = ["NODE_OPTIONS", "NODE_ENV"]
key_files = ["node_modules/.package-lock.json"]
env = { CI = "1" }
sluice doctor avisa cuando un gate se las deja fuera:
[warn] key-env gate 'test': key_env leaves out RUSTFLAGS, RUSTDOCFLAGS, CARGO_BUILD_TARGET (a change to them reuses a pass made with other values); needs sluice >= 0.11.0 to read key_envAñadir key_env cambia la clave de cada gate una vez, así que cada uno vuelve a ejecutarse una vez.
Un daemon no debe heredar a quien lo arranca
Todos los trabajos descienden del daemon, y la sesión de un agente puede arrancarlo por su cuenta. Desde la 0.12.0, el daemon no se queda con el entorno de quien lo arranca, así que el id, la dirección de la API y el token de portador de la sesión de un agente nunca llegan a los trabajos de los demás. Una comprobación del tipo “¿estoy debajo de un agente?” que suba por el árbol de procesos ya no confunde tus ejecuciones con las de un agente, y los merge trains, que ejecutan sus gates, su prepare y sus key_inputs con el entorno del daemon, nunca ven el token.
El daemon solo conserva una lista permitida (PATH, HOME, el idioma, XDG_*, el bus de sesión, SLUICE_* y pocas más), y un sluice daemon lanzado a mano se vuelve a ejecutar limpio. El log nombra las variables descartadas que parecen credenciales, sin enseñar su valor. Los gates que lanzan run, verify o un hook siguen recibiendo el entorno de quien los pide. Las claves de API que exporta el perfil de tu shell ya no llegan al daemon: los merge trains las sacan de tu shell de inicio de sesión (el tool_env por defecto), y con [queue] tool_env = "daemon" tienes que poner las que necesiten, como un proxy, en pass_env.
# ~/.config/sluice/config.toml
[daemon]
pass_env = ["HTTPS_PROXY"]
Y un gate puede quitar variables de su propio entorno con env_remove, para marcadores que env no puede borrar.
Actualiza a la 0.12.2
sluice updateComprueba el checksum y solo para el daemon si está inactivo; uno que está ejecutando gates sigue hasta su próximo reinicio. Si usas el plugin de Claude Code, actualízalo también, y después reinicia las sesiones de tus agentes, que siguen con el sluice mcp antiguo hasta que se reconectan:
claude plugin marketplace update sluice
claude plugin update sluice@sluice
Después, compruébalo:
sluice doctor   # daemon-version y plugin dicen 0.12.2, más los avisos de key_env si los hay
sluice status   # la versión del daemon, y la línea memory: con la presión del escritorio
La 0.12.1 corrige la detección de fugas de la 0.11.0 y la 0.12.0. Si estás en alguna de las dos y todavía no puedes actualizar, desactiva el manejo de fugas en tu configuración de usuario:
# ~/.config/sluice/config.toml
[containment]
reclaim_escaped = false
y reinicia el daemon cuando esté inactivo con sluice daemon stop (descarta los trabajos en cola). Con false, Sluice ni devuelve procesos ni mata lo que quede al acabar un trabajo; la detección sigue funcionando, así que puedes ver una ráfaga de líneas WARN. Cuando hayas actualizado, quita la línea para recuperar la contención, salvo que la necesiten tus propios tests.
Ninguna de estas versiones rompe una configuración existente. Las claves nuevas van en un solo sentido: un .sluice.toml compartido que use key_env necesita la 0.11.0 o posterior en todas las máquinas, y uno que use env_remove, la 0.12.0.
Pruébalo
Necesitas Linux. La contención necesita cgroup v2 y un gestor de usuario de systemd, y la política de memoria, systemd-oomd con systemd 257 o posterior; en un contenedor o con cgroup v1, Sluice corre sin contención y sluice doctor te dice por qué. Todo el trabajo de memoria de este artículo sale de máquinas con Ubuntu 26.04 y kernel 7.0.
Si llegas nuevo: en un runner de GitHub de 4 CPU, con la 0.9.0 (mediana de 3 rondas), Sluice bajó el tiempo hasta que todos los agentes habían hecho su commit de 103 a 72 s con 4 agentes (−30 %) y de 213 a 119 s con 8 (−44 %).
curl -fsSL https://raw.githubusercontent.com/josegarridodigio/sluice/main/scripts/install.sh | sh
sluice doctor
sluice init --dry-run
sluice init
El código, el CHANGELOG y la decisión detrás de cada cambio (de la ADR-0026 a la ADR-0030) están en github.com/josegarridodigio/sluice. Si te resulta útil, una estrella ahí ayuda a que otros lo encuentren. Y si quieres enterarte de la próxima versión cuando salga, con lo que voy aprendiendo al usarlo, tienes la newsletter justo debajo.