Sluice encola los tests, builds y comandos pesados de tus agentes de IA con presupuesto común de CPU y memoria, y ejecuta cada check una vez por árbol de git.
 José Antonio Garrido
Sluice es una cola y una caché de verificación compartidas por todos los agentes de IA de una máquina Linux: ejecuta cada gate (tests, linters, type checks) una sola vez por árbol de git, bajo un presupuesto común de CPU y memoria, y guarda el resultado. Es de código abierto (licencia MIT), está escrito en Rust y funciona con cualquier agente de IA de programación: los hooks de git no necesitan nada del agente, los agentes que soportan MCP se conectan a su servidor MCP y para Claude Code hay además un plugin. Lo hice yo, y en este artículo te cuento por qué, cómo se instala y qué ha cambiado en mis máquinas, con los números medidos.
¿Qué problema resuelve?
En mi trabajo desarrollo software para clientes con agentes de IA. En un día normal tengo decenas de agentes a la vez (yo uso Claude Code), cada uno en su propio worktree de git, sobre proyectos con verificaciones caras: suites de tests de varios minutos, linters y type checks metidos en pre-commit y pre-push. Son hooks que define el equipo de cada proyecto y que no siempre puedo tocar.
Nada coordinaba a esos agentes. Trabajando con varios agentes de IA en paralelo, mi máquina se pasaba el día ejecutando los mismos tests y builds una y otra vez, hasta quedarse sin memoria, y los pushes tardaban una eternidad. Lo que me hizo decir “basta” fue ver el escritorio rendirse: GNOME dejaba de responder y Linux empezaba a matar procesos por su cuenta. El OOM killer del kernel se llevaba por delante el navegador y las aplicaciones, y systemd-oomd, las herramientas de los propios agentes.
Detrás había tres causas distintas:
- Concurrencia sin control. Cada agente lanza sus verificaciones por su cuenta, directamente o desde los hooks de git.
- Redundancia. El mismo árbol se verifica muchas veces: el agente antes de commitear, después
pre-commit, despuéspre-push(que repite lo depre-commit) y otra vez tras un rebase que no cambia nada. Lo he medido con el propio Sluice: de todas las verificaciones que se pidieron, el 52 % en el equipo de desarrollo (1.426 de 2.742) y el 38 % en el segundo equipo (1.142 de 3.016) eran sobre código que ya estaba verificado. - Alcance excesivo. Suites completas donde bastaría un subconjunto. Eso es cosa de cada proyecto, no de Sluice.
Y una restricción que lo complica todo: la herramienta de shell de un agente tiene un timeout. Un hook que se queda esperando en una cola dentro de git commit acaba cortado, y el agente sigue sin saber si el commit se hizo. Por eso Sluice responde rápido en los hooks y espera de verdad por MCP.
¿Qué necesitas?
- Linux (solo funciona en Linux) con
git2.31 o posterior. Hay binarios estáticos para x86_64 y aarch64. - Un agente de IA de programación. Cualquier agente que soporte MCP puede usar el servidor MCP (
sluice mcp); para Claude Code hay además un plugin que lo deja todo listo. - Para aislar los trabajos: cgroup v2 y un gestor de usuario de systemd. La política de memoria usa
systemd-oomdcon systemd 257 o posterior.sluice doctorte dice qué tienes.
¿Cómo lo instalo?
El binario se instala en ~/.local/bin:
curl -fsSL https://raw.githubusercontent.com/josegarridodigio/sluice/main/scripts/install.sh | shSLUICE_VERSION fija una versión concreta y, más adelante, sluice update actualiza en el sitio verificando la suma de comprobación. Después conecta tu agente. En Claude Code, instala el plugin:
/plugin marketplace add josegarridodigio/sluice
/plugin install sluice@sluice
Con cualquier otro agente que soporte MCP, registra sluice mcp como servidor MCP en su configuración y pega en su AGENTS.md el bloque de instrucciones de la guía de agentes. Si el agente no define ninguna variable que Sluice reconozca, exporta SLUICE_AGENT=1 en su shell para que los hooks sepan que es un agente; y si solo tiene shell, sluice shim install, con el directorio de los shims primero en su PATH, mete también sus builds y tests en la cola.
Y en cada repositorio, primero mira qué haría y después escríbelo:
sluice init --dry-run   # detecta el stack y tus hooks; muestra el plan, no escribe nada
sluice init             # escribe .sluice.toml y reconecta tus hooks
Con el plugin de Claude Code no hay que tocar el PATH ni el CLAUDE.md: al empezar cada sesión, instala unos shims de shell, los pone primero en el PATH de la sesión y le da al agente las reglas. Un gate es un comando con nombre en .sluice.toml:
version = 1

[gates.test]
cmd = "npm test -- --maxWorkers=2"
weight = 4
hooks = ["pre-commit", "pre-push"]
weight es cuántas unidades del presupuesto ocupa el gate, más o menos los hilos de CPU que usa. Con weight = "auto", Sluice empieza en la mitad del presupuesto y aprende uno más bajo de las ejecuciones medidas.
¿Qué pasa cuando un árbol ya pasó?
Que no se vuelve a ejecutar. La clave de la caché es el contenido exacto del árbol de trabajo más la definición del gate, y la comparten todos los worktrees del repositorio. Si otro agente, o tu hook de pre-commit, ya verificó ese árbol, la respuesta llega desde la caché sin pasar siquiera por el demonio:
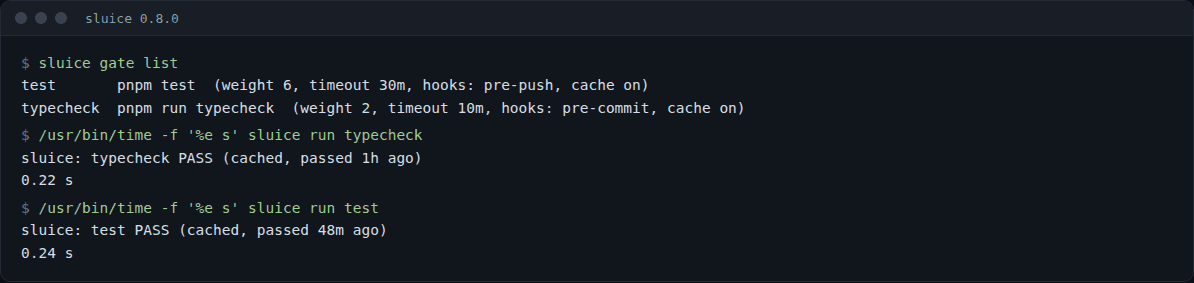
Ese typecheck tardó 54 segundos la última vez que se ejecutó de verdad; ahora contesta en 0,22 s. En este repositorio la respuesta incluye ejecutar pnpm --version, porque está declarado en key_inputs: la salida de esos comandos entra en la clave, para que cambiar de versión de pnpm invalide la caché, y se ejecutan en cada consulta. Sin ellos, en mi equipo de desarrollo, una respuesta desde caché cuesta unos 25–30 ms.
Si quieres ver por qué Sluice decide lo que decide, --explain te enseña el árbol, la clave y el resultado de la búsqueda sin ejecutar nada:
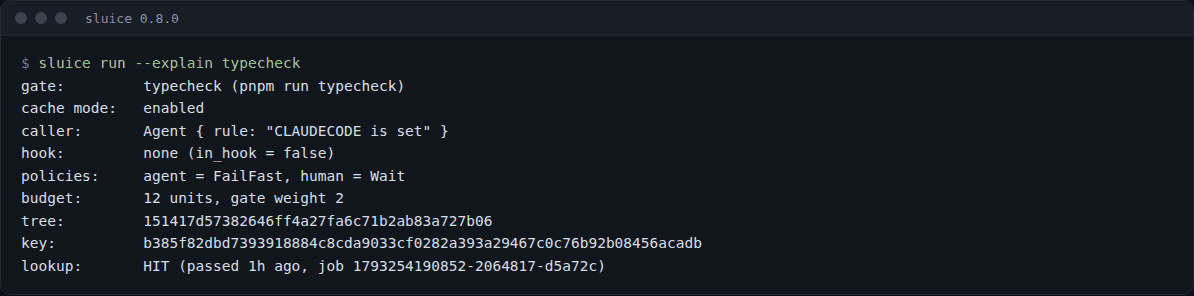
Si dos agentes piden lo mismo a la vez, se ejecuta una vez y los dos reciben el resultado (coalescing).
Esto es lo que se ha ahorrado, medido en la base de datos de cada demonio, sin contar los trabajos cancelados:
| Segundo equipo (12 hilos, 30 GB) | Equipo de desarrollo (20 hilos, 30 GB) | |
|---|---|---|
| Periodo | 24 → 29 oct (5,8 días) | 22 → 28 oct |
| Verificaciones ejecutadas | 1.874 | 1.316 |
| Respuestas desde caché | 1.142 | 1.426 |
| Tiempo de ejecución ahorrado | 19,2 horas | 8,6 horas |
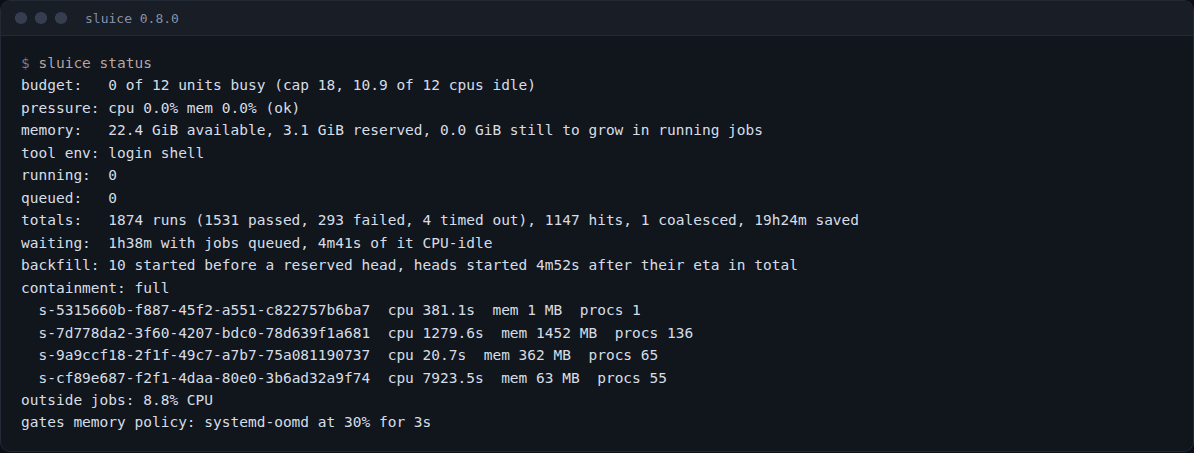
En total, unas 28 horas de tests y linters que no se ejecutaron en una semana, porque ese código exacto ya estaba verificado. En el segundo equipo, el ahorro diario va de 1,9 a 5 horas. La captura del principio es de ese equipo, unas horas después, con algunas respuestas más desde caché.
Sluice no acelera los tests: evita repetirlos, ordena cuándo se ejecutan y protege la máquina.
¿Cómo evita que la máquina se quede sin memoria?
En el segundo equipo, con 5 agentes trabajando a la vez, el registro del sistema muestra episodios de falta de memoria en tres días distintos (22, 25 y 26 de octubre). En el peor, el 26 por la mañana, el sistema estuvo matando procesos durante unos 20 minutos, hasta 6 por minuto. Sluice registró 15 intervenciones del kernel o de systemd-oomd sobre sesiones de agentes, y un solo gate llegó a ocupar 18 GB.
La versión 0.6.0 (26 de octubre) cambió tres cosas:
- Admisión por memoria. Sluice aprende cuánta memoria usa cada gate (el mayor working set de sus últimas 5 ejecuciones, más un 20 %) y no arranca uno que no cabe en la memoria disponible menos una reserva para el escritorio y los agentes (por defecto, un 10 % de la memoria).
- Aislamiento. Cada trabajo corre en su propio cgroup.
- Víctimas preferentes. Si aun así falta memoria, el kernel y
systemd-oomdeligen antes un trabajo de verificación que tu escritorio o tus agentes.
sluice doctor te enseña cómo queda configurado en tu máquina:
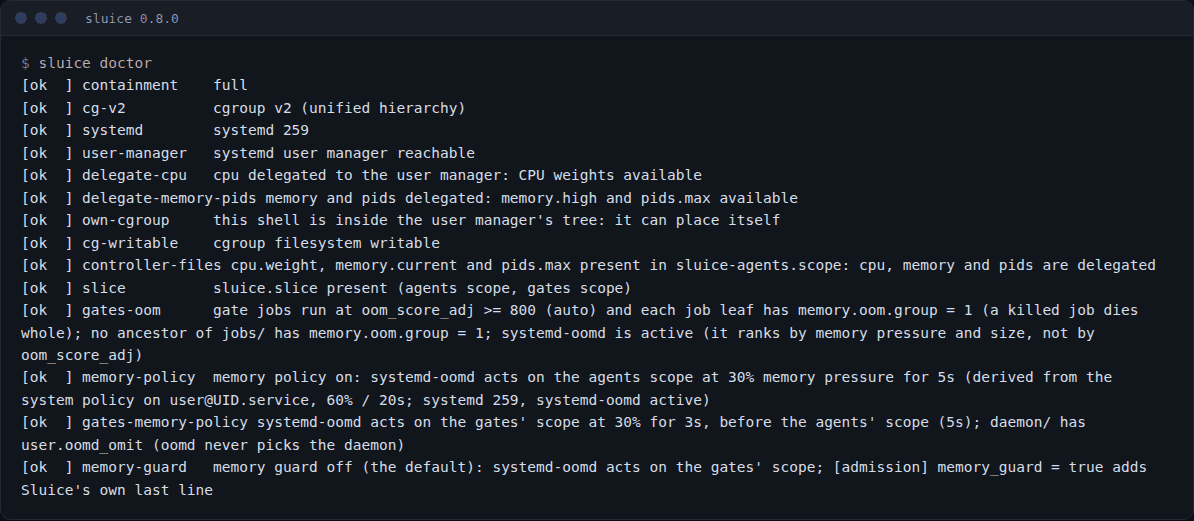
Desde el 26 de octubre por la tarde: 0 episodios de falta de memoria en el segundo equipo, en unas 780 verificaciones y 2,5 días de agentes trabajando, noches incluidas. No cuento una prueba deliberada y acotada que hice ese mismo día a mediodía.
La 0.8.0 arregló el caso contrario: un gate sin historial reservaba una estimación inflada. Un pytest reservó 13,8 GB, esperó 26 minutos, se ejecutó en 1 min 40 s y usó en torno a 1 GB. Ahora la primera ejecución arranca como sonda, mide lo que usa de verdad y aprende también de las que fallan: las esperas por estimaciones adivinadas pasaron de 7 en un día a 0 la primera noche.
¿Por qué un linter de 0,1 segundos esperaba 23 minutos?
Porque esperaba detrás de un gigante. El 28 de octubre, con la versión anterior, la suite de tests de un monorepo pnpm usaba unos 12 GB en cada ejecución (20 ejecuciones medidas, entre 11 y 13 GB). Con 30 GB solo cabe una a la vez. Cuando esa suite esperaba memoria en cabeza de la cola, reservaba su turno y todo lo demás esperaba detrás:
- un linter que tarda 0,1 segundos esperó entre 15 y 23 minutos;
- un
typecheckde 19 segundos esperó unos 4 minutos; - el 48 % de todo el tiempo en cola fue de este tipo, y el 91 % de esos trabajos duraban menos de un minuto.
Mientras tanto, la CPU estaba casi parada: un 40 % del tiempo con trabajos en cola, estaba ociosa.
La 0.8.0 trae backfilling, la técnica de planificadores de supercomputación como Slurm. Sluice predice cuándo podrá empezar la cabeza a partir de lo que tardan los trabajos en marcha, y deja pasar a uno de detrás solo si cabe ahora y no la retrasa: porque la cabeza seguirá cabiendo a su lado, o porque su duración aprendida, con margen, termina antes. [scheduler] backfill = false vuelve a la reserva estricta.
| Antes: día del 28 oct, 12 h | Después: noche del 28 al 29 con 0.8.0, 12 h | |
|---|---|---|
| Verificaciones | 316 | 202 |
| Minutos de ejecución | 510 | 380 |
| Minutos de espera en cola | 981 | 167 |
| Espera por minuto de trabajo | 1,92 min | 0,44 min |
| Peor espera de un trabajo de menos de 1 min | 27 min | 12 min |
| CPU ociosa mientras había cola | ~40 % | 4,8 % |
| Trabajos que adelantaron a la cabeza | — | 10 |
| Retraso total que eso causó a las cabezas | — | 4 min 52 s |
Léela con cuidado: no es un experimento controlado. Son 12 horas de día con la versión vieja contra 12 horas de noche con la nueva, con cargas distintas. Por eso comparo la espera por minuto de trabajo, unas 4,4 veces menor, y no la espera absoluta. Y hay un coste: dejar pasar trabajos retrasó 4 min 52 s en total a las cabezas esa noche. Sluice lo mide y lo enseña en sluice status (la línea backfill de la captura del principio) precisamente para vigilarlo.
¿Y si un test se queda colgado?
El 28 de octubre, los tests de un proyecto se quedaron colgados cuatro veces, esperando algo que nunca llegaba. Cada vez ocuparon la cola y hasta 7,6 GB de memoria durante los 30 minutos del límite. En tres de ellas los tests ya habían terminado y un solo fichero se quedó colgado 25 minutos o más.
Desde la 0.8.0, cada 5 segundos el demonio mira lo que hace cada trabajo: tiempo de CPU, E/S de disco, fallos de página, número de procesos y bytes de log. Un trabajo sin ningún progreso durante max(5 min, 3 × su duración habitual) aparece como STALLED en sluice status, y el agente recibe el aviso en el progreso de verify. Sluice nunca lo mata: el timeout del gate sigue siendo el único límite. Lo decidí así para no tener ningún falso positivo que cueste un trabajo bueno. Un gate que debe estar quieto (un watch, un servidor) puede poner stall_timeout = "off".
La primera noche: 0 cuelgues y 0 falsos avisos en 177 trabajos. El silencio más largo de cualquier trabajo fue de 20 segundos.
¿Y si no puedo tocar los hooks del repositorio?
Me pasó en un repositorio Angular de un cliente que usa husky. Los hooks son del cliente y de su equipo, así que no podía reescribirlos, y husky antepone su propio PATH: los tests de cada commit se ejecutaban fuera de la cola y de la caché. Minutos por commit, compitiendo con todo lo demás.
Desde la 0.7.0, Sluice puede ser el punto de entrada de los hooks de tu clon sin modificar el repositorio:
sluice hooks on       # o, al configurarlo: sluice init --hooks entry
sluice hooks status   # qué hook va por la cola y cuál se delega, y por qué
on apunta core.hooksPath a un directorio de hooks dentro del directorio de git del clon, desde un fichero incluido en su configuración, así que la escritura de husky en cada instalación no lo desplaza. off lo quita, y si falta el binario de sluice, los hooks del repositorio siguen funcionando.
La regla de diseño es: o lo entiendo entero, o lo ejecuto intacto. Antes de escribirlo leí el código fuente de husky, lefthook y pre-commit. Un hook que Sluice entiende completamente ejecuta sus comandos como trabajos de la cola, en el orden del gestor: los de solo lectura, como tests o linters, van a la caché, y los que pueden cambiar ficheros, como lint-staged, se ejecutan siempre. Cualquier otro hook se ejecuta exactamente como antes.
En un repositorio sin .sluice.toml, esas unidades de los hooks pasan a ser los gates de verify, con las mismas entradas de caché: un verify antes de git commit convierte el hook del commit en una respuesta desde caché.
¿Cómo lo usa un agente sin chocar con el timeout del shell?
Por MCP. sluice mcp ofrece una herramienta verify que bloquea hasta que terminan los gates y manda una notificación de progreso cada 15 segundos. Claude Code, por ejemplo, solo corta una llamada MCP si pasa su ventana de inactividad (30 minutos por defecto) sin respuesta ni progreso, así que el agente espera lo que haga falta, sin el límite del shell.
En Claude Code, el resto del plugin lleva al agente por ahí: una skill que le enseña a usar verify y la cola de merge, y un guard que reescribe los comandos de los gates a sluice run <gate> -v y los pesados (builds, test runners) a sluice exec -- ..., para que compartan el presupuesto. Con otros agentes, el bloque de AGENTS.md lleva las mismas instrucciones que la skill. Y si un agente hace commit con un árbol que no está en caché, el hook reconectado por sluice init contesta al momento con el código de salida 3 y le dice que use verify, en lugar de quedarse esperando dentro de git commit.
¿Cómo integro las ramas de varios agentes?
Con la cola de merge local. Un agente termina su rama, pasa verify, hace commit y la encola. El demonio combina las ramas encoladas sobre el destino en un worktree desechable (un “tren”) y ejecuta los gates una vez sobre el árbol combinado, con la misma caché y el mismo presupuesto:
sluice queue enqueue           # lo hace el agente, o tú
sluice queue status            # el plan: trenes, conflictos y qué está listo
sluice queue approve <tren>    # lo haces tú
Por defecto, nada se empuja hasta que una persona aprueba el tren: el demonio rechaza la aprobación de un agente, por MCP o desde la terminal, y el plugin de Claude Code también se la bloquea. Puedes permitirla de forma explícita en tu configuración personal (allow_agent_approval = true); un repositorio no puede activarla por su cuenta. Aun así, dos casos siguen siendo solo humanos: un tren que cambia la propia configuración de verificación del proyecto y el aterrizaje mediante pull request. Si tu rama de destino está protegida y solo acepta pull requests, [queue] land = "pull-request" empuja el resultado verificado a una rama sluice/train/<id> y, al aprobar, abre el pull request con tu propio gh. Sluice nunca hace el merge.
¿Cómo lo construí?
Con agentes de IA, y verificado con el propio Sluice: cada commit del proyecto pasa por su propia cola y su propia caché. El primer commit es del 22 de octubre y la 0.8.0 salió el 28: de la 0.1.0 a la 0.8.0 en una semana, con unos 190 commits, unas 105.000 líneas de Rust y 25 decisiones de arquitectura (ADR) documentadas en el repositorio.
Cada cambio grande siguió el mismo ciclo: análisis del código y de datos reales de las dos máquinas, propuestas con sus riesgos, mi decisión registrada en un ADR, implementación por oleadas con agentes y revisión. Antes de cada versión, CI en 7 combinaciones: Ubuntu 22.04 y 24.04, Debian, Fedora, Alpine, ARM y la versión mínima de git. Varias veces la revisión encontró errores que los tests no veían, y el CI destapó problemas que solo existían en Alpine o en Fedora. Y casi cada versión nació de un problema que vi usando Sluice a diario: la memoria en la 0.6.0, los hooks en la 0.7.0 y la cola atascada en la 0.8.0.
Pruébalo
Instala el binario y conecta tu agente como arriba, y en tu repositorio:
sluice doctor
sluice init --dry-run
sluice init
sluice status
El código, la documentación y los 25 ADR están en github.com/josegarridodigio/sluice. Si algo no te funciona, sluice doctor --bundle genera un paquete de diagnóstico, con los datos sensibles eliminados, para adjuntarlo a un issue.